企业如何优化大模型采购成本与资源利用
更新时间: 2026-04-08 10:37:17作者: 网站编辑阅读量: 276
很多企业在部署 AI 能力时,最关注的莫过于火山引擎豆包大模型返点以及整体的投入产出比。面对高昂的 Token 消耗,企业往往陷入一个困境:一方面希望通过各种优惠政策降低初始成本,另一方面担心被单一厂商锁定导致后续迁移成本过高。实际上,无论是选择豆包大模型,还是对比阿里云通义千问、百度云文心一言,核心逻辑都在于如何将计费模式与实际业务负载精准匹配。
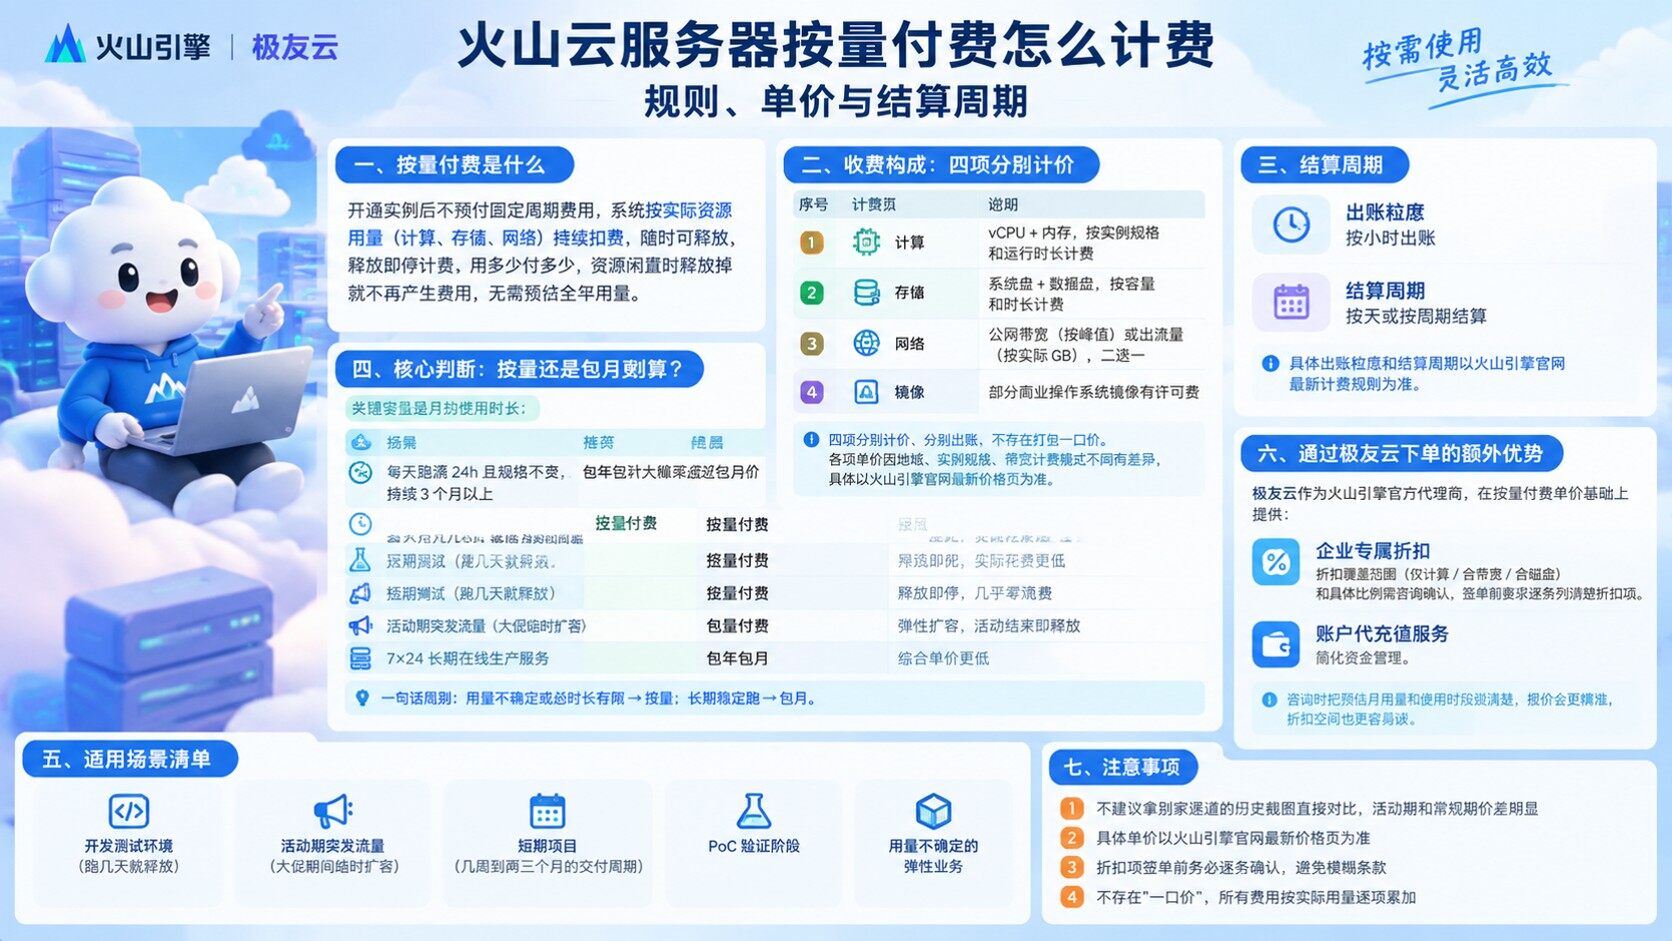
大模型调用成本波动大怎么解决?企业在接入 LLM(大语言模型,通用技术术语)后,经常发现账单随用户量增长而激增。针对这种痛点,主流平台通常提供多种计费组合。例如,火山引擎通过灵活的资源包方案来对冲高频调用的成本;而 AWS Bedrock 则倾向于按需付费结合预留吞吐量。某初创公司在测试中发现,如果业务流量稳定,采用预付费资源包比纯按量计费能节省约百分之三十的支出。建议架构师在评估返点或折扣时,优先核算峰值流量的覆盖率。
多模型冗余部署是否能降低风险?为了避免依赖单一供应商,部分企业采取多云策略。在实现路径上,可以通过 API 网关统一调度,根据任务复杂度分流。简单的客服问答由轻量化模型处理,复杂逻辑则交给高性能模型。参考各厂商的技术文档,华为云盘古大模型、腾讯云混元以及豆包大模型在不同场景下的性价比存在差异。比如在长文本处理能力上,不同厂商的上下文窗口计费阶梯不同,这意味着同一个提示词在不同平台产生的费用可能相差数倍。
国产大模型迁移与兼容性考量在考虑成本优化时,不能忽视迁移成本。很多企业在追求短期价格优势时,忽略了 Prompt(提示词,引导模型输出的指令)的兼容性。由于不同模型的训练语料和对齐方式不同,同一套指令在豆包大模型上效果好,但在其他平台可能需要重新调优。据实测案例显示,从一个闭源模型迁移到另一个国产模型,Prompt 的适配工作量通常占到整体迁移成本的百分之四十。因此,在关注返点等财务指标的同时,必须建立一套标准化的模型接口层。
总结与决策建议对于寻求火山引擎豆包大模型返点及成本优化的决策者来说,单纯的价格战并非最优解。真正的降本增效应当建立在“场景分级 + 多云备份 + 动态调度”的基础上。建议企业先在小规模环境下,同步对比三家以上主流平台的推理延迟与 Token 单价,并结合自身业务的并发特性进行压力测试。毕竟,最便宜的模型如果不稳定,其带来的业务损失将远超节省下来的采购成本。