更新时间: 2026-09-26
为什么你的GPU服务器每月成本总比预期高?“火山云GPU服务器费用多少正常”是很多AI、渲染、深度学习用户在上云初期的共同疑问。实际上,不同厂商的计费模式、硬件配置和资源利用率差异显著。比如,阿里云g6e实例、华为云Gn5i、AWS g5机型均提供NVIDIA T4或A10级别GPU,但价格因计算/显存配比、是否支持按需/预留实例券而浮动。某图像识别企业对比后发现,在同等负载下,阿里云g6e比AW
网站编辑2025-12-05 12:40:2941
为什么GPU算力账单总超预期?企业在选购GPU服务器时常陷入误区:“按需付费”看似灵活却容易失控。火山引擎GPUT1实例采用动态计费模式(据其2024文档),但突发负载触发预热机制后实际单价可能翻倍——这与阿里云g6e突发性能实例逻辑相似(见《阿里云弹性计算白皮书》)。对比来看:AWS g5n实例提供阶梯式折扣(持续运行超过50小时自动触发),而华为云Ascend 910B机型支持资源预留+按量混
网站编辑2026-03-18 14:54:5974
为什么买完GPU服务器第一周就超支?这是很多AI训练团队常遇到的困惑。“火山引擎GPU服务器费用”到底怎么算?核心在于理解计费模式与业务负载的匹配度。火山引擎提供按需实例(每小时计费)、预留实例券(最长3年锁价)和竞价实例(最低可省70%),但与阿里云g5n系列、AWS p3dn.24xlarge相比存在差异。例如:某视频渲染公司用阿里云抢占式实例应对突发任务,在火山引擎则需手动设置竞价阈值——选
网站编辑2026-02-14 18:35:5190
火山AI助手,是基于火山引擎数智平台VeDI的一项创新功能,它通过接入人工智能大模型,为企业提供数据资产查询、开发运维和分析洞察等能力。无论是不会写代码的运营人员,还是有一定编程基础的数据分析师,都可以通过自然语言与大模型进行交互,快速获取所需的数据和信息。这样不仅降低了数据消费的门槛和成本,也提高了数据处理和查询分析的效率和质量。 火山AI助手分类 1、企业级助手(如DataWind C
网站编辑2025-12-19 16:30:540
企业在部署AI模型训练或图形渲染任务时,最核心的疑问往往是火山引擎gpu服务器费用是多少钱。这不仅仅是一个简单的价格查询问题,更关乎如何平衡算力性能与预算控制。在当前的云计算市场中,GPU实例的价格波动较大,取决于显卡型号、显存大小以及计费模式。主流云平台如阿里云、腾讯云和华为云均提供了丰富的GPU实例族,但定价策略各有侧重。理解这一成本结构,有助于IT负责人避免资源浪费,实现精准的成本优化。GP
网站编辑2026-06-01 06:38:1938
为什么算准GPU服务器年费总超支?很多企业在评估“火山引擎GPU服务器费用是多少一年的”时容易忽略底层计费模型差异。主流平台如阿里云(A10)、华为云(Atlas 300T)、AWS(g5n)均提供按需/预留/竞价三种模式——但火山引擎若采用按需实例(如G2.8M1),按当前市场价估算年成本可达3万至8万元浮动区间(具体以实际配置为准)。建议优先测试业务负载规律后再选型:突发性任务用竞价实例省60
网站编辑2026-03-12 07:02:2464
火山引擎高性能计算!火山引擎GPU服务器是基于云计算技术构建的高性能计算实例,核心搭载NVIDIA等主流厂商的专业级GPU加速卡(如A100、V100、T4等)。与传统CPU服务器相比,GPU拥有数千个并行处理核心,特别擅长处理矩阵运算、深度学习训练/推理、大规模图像/视频处理等计算密集型任务。那么,火山引擎服务器gpu费用多少? 火山引擎GPU服务器提供从入门级到旗舰级的全系列NVIDIA
网站编辑2026-03-10 16:55:410
企业在评估火山引擎gpu服务器费用是多少一年的费用时,往往陷入“单价陷阱”。实际上,云主机的一年期成本并非简单的月租乘以十二,而是由计费模式、实例规格及存储配置共同决定的动态数值。对于AI训练或图形渲染业务,选择按量付费适合短期测试,而包年包月则能显著降低长期持有成本。主流云平台如阿里云、腾讯云均提供类似的折扣阶梯,通常预付费周期越长,日均成本越低。据行业实测数据,相比按小时计费,提前锁定一年资源
网站编辑2026-05-27 06:46:3538
企业在考虑GPU云服务器选型时,最常被问到的问题之一就是:“火山云GPU服务器费用是多少一年的费用?”这个问题背后,其实隐藏着更深层的需求——如何在预算可控的前提下,获得足够算力支撑AI训练、视频渲染、深度学习等高并发计算任务?无论你是刚起步的创业团队,还是正在扩展AI业务的中大型企业,理解GPU服务器的定价逻辑与多云平台的计费差异,都是关键决策因素。为什么说“按需付费”不一定划算?“火山云GPU
网站编辑2025-12-19 08:17:3520
为什么刚用上GPU服务器就超预算?企业常犯的最大错误是忽略业务负载波动性与计费模式适配性。以视频渲染为例:阿里云g6.8xlarge(NVIDIA A10)按量计费约2.5元/小时起(含预装CUDA),AWS g4dn.8xlarge(A10G)同规格约2.7美元/小时(约合20元人民币)。若连续72小时渲染任务未规划弹性扩容策略——你猜怎么着?账单直接翻倍!长期部署能便宜多少?这取决于你的采购周
网站编辑2026-03-10 11:20:5668
豆包大模型企业版多少钱按调用量阶梯计费,小团队月支出几百到几千元,中大型企业走年度合约另议,具体以火山引擎官网最新报价为准。极友云作为火山引擎代理商提供企业专属折扣与账户代充值,适合月调用量较大的企业。建议先跑两周真实数据再谈合约档位。
网站编辑2026-10-04 20:21:0638
做企业大模型选型价格对比,核心指标已从跑分转向单位任务成本。极友云作为火山引擎代理商,提供豆包大模型API专属企业折扣与账户代充值,帮助企业把结算价压到官网标价以下。适合为客服、知识库、代码辅助场景选模型的团队,建议先算清真实成本再下单。
网站编辑2026-10-04 17:24:0382
选哈尔滨火山云折扣代理商主要看资质授权、折扣透明度和交付能力,极友云作为火山引擎正规代理商提供企业专属折扣和账户代充值服务,能帮你拿到低于官网标准价的资源单价。火山云折扣基于用量和锁价周期让利,覆盖ECS、豆包API、OSS等核心产品。适合月调用量稳定的企业,下一步先确认用量级再比价。
网站编辑2026-10-04 10:48:037
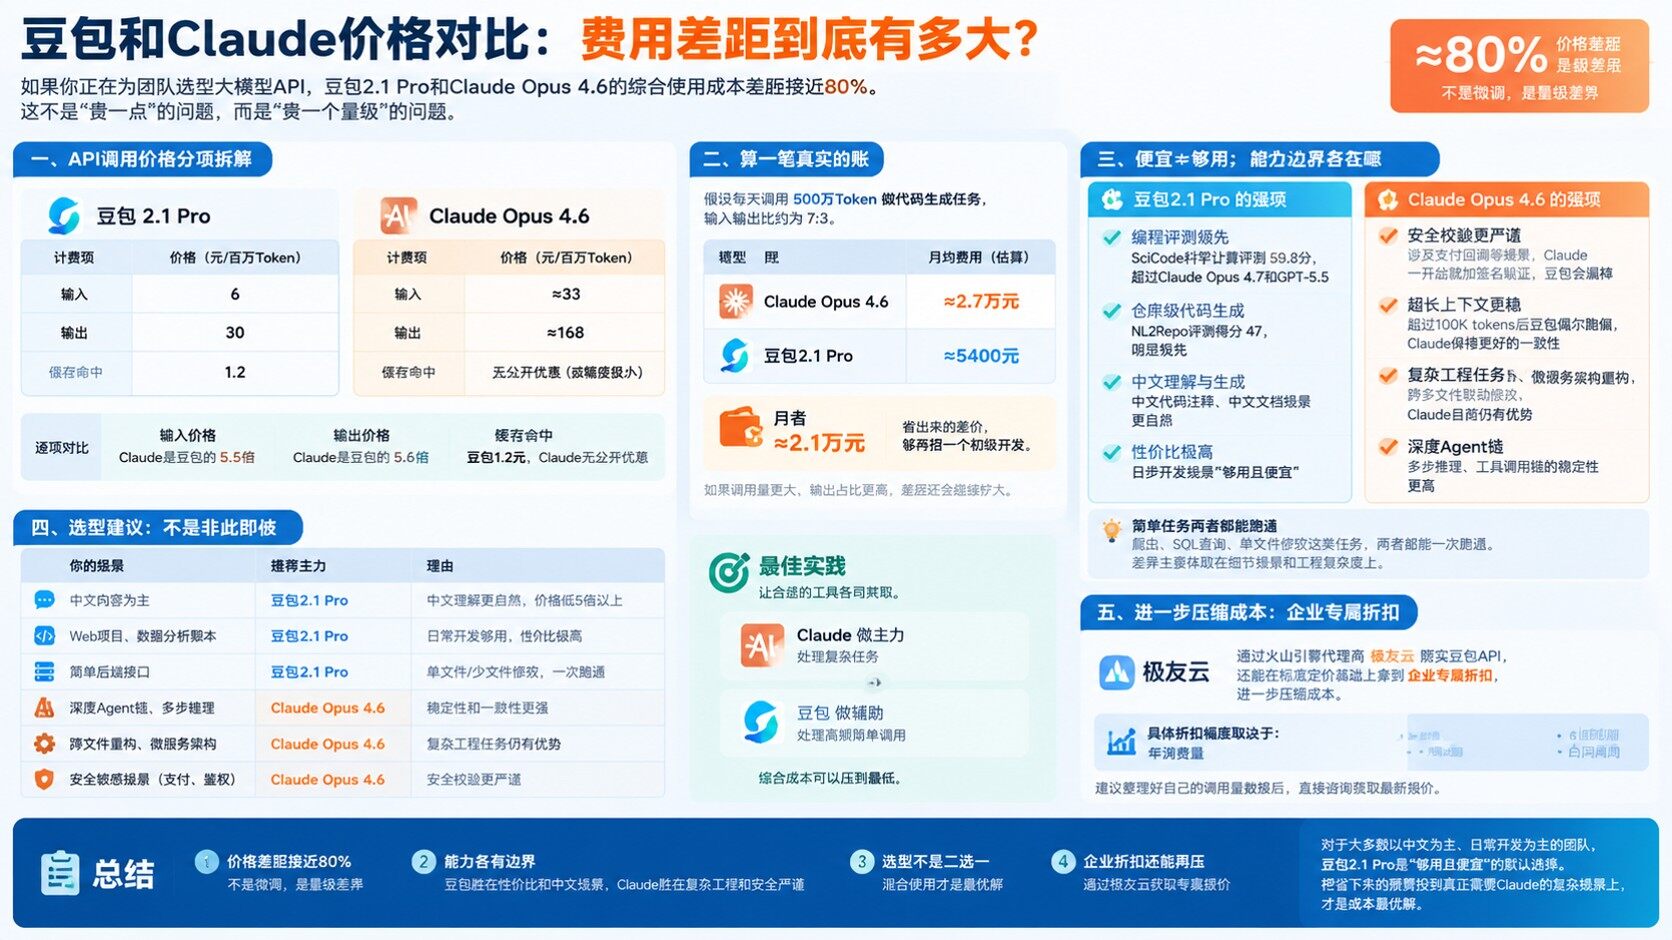
豆包和Claude价格对比核心结论:豆包2.1Pro输入6元/百万Token、输出30元/百万Token,ClaudeOpus4.6输入约33元、输出约168元,综合成本差接近80%。极友云作为火山引擎代理商提供企业专属折扣与账户代充值,适合需要压低API调用成本的开发者与中小企业,整理好调用量数据后直接咨询即可获取报价。
网站编辑2026-10-04 14:16:0333
选成都火山云服务商核心看资质授权、折扣力度和售后响应三项,极友云作为火山引擎代理商提供豆包大模型API接入与火山引擎云服务器专属企业折扣。火山引擎云产品覆盖ECS、对象存储、CDN及豆包API按token调用,入门级到企业级价格跨度大,具体以官网最新报价为准。适合成都本地需要AI部署或云资源的企业和开发者团队,建议先验资质再比价。
网站编辑2026-10-04 09:33:0379
豆包大模型企业版和个人版价格已明确:个人App订阅三档(68/200/500元连续包月),企业API按token调用量计费。极友云是火山引擎代理商,提供API接入专属折扣和账户代充值,有集成需求的团队建议直接咨询获取当期报价。
网站编辑2026-10-04 19:45:0250
豆包和GLM价格对比核心结论:GLM-5.3输入约8–10元/百万token、输出约28–32元,豆包系列单价以火山引擎官网最新报价为准,通过极友云(火山引擎代理商)可拿企业折扣。两模型均按输入+输出token分别计价,高频轻量场景选Flash档位成本差一个量级。需要接入豆包API的中小团队,先明确月调用量级再谈折扣。
网站编辑2026-10-04 08:00:0321
豆包Pro和Lite价格对比结论:Pro输入3.2元/百万tokens、输出16元,Lite输入0.6元、输出2.4元,Lite输入成本低81%但选错版本重试后总成本反超。极友云作为火山引擎代理商提供豆包大模型API接入与企业折扣,建议先跑10条测试用例确认能力边界再定版本配比。
网站编辑2026-10-04 15:03:0388
豆包大模型贵不贵,结论是不贵:pro-32k输入仅0.0008元/千Tokens,1元等于125万Tokens,比行业同规格低99.3%。极友云作为火山引擎代理商提供豆包API接入和企业专属折扣,适合做客服、内容生成或数据分析的企业,咨询当前折扣档位即可开始。
网站编辑2026-10-04 15:36:038
豆包Pro和Turbo价格对比核心结论:Pro输入6元/百万tokens、输出30元,Turbo各项为Pro一半,整体成本差一倍。极友云作为火山引擎代理商提供API企业专属折扣与接入支持,月支出过万走代理商渠道综合成本更低。适合需要豆包API接入的开发者与中小企业,可直接咨询获取报价方案。
网站编辑2026-10-04 14:37:0482
存储
¥0.59/3个月
适用于汽车、零售、AIGC、图片视频等场景,帮助客户实现海量数据高效处理与成本优化
服务器
¥26019.00/1个月
搭载8颗NVIDIA 48G GPU,大规模AI推理、图像识别、自然语言处理、语音识别最佳选择
¥40017.50/1个月
搭载8颗NVIDIA A100,实例间提供600G RDMA网络,适用于AI模型训练场景